¿Alguna vez has copiado un texto desde una página web o una respuesta de IA y tu código deja de funcionar? O peor aún, el buscador no encuentra una palabra que claramente está ahí. La culpa suele ser de algo invisible para el ojo humano pero muy presente para la máquina: los caracteres de ancho cero. No son errores del sistema, sino parte del estándar Unicode diseñados para controlar cómo se rompen las líneas, cómo se unen los emojis o cómo se leen los archivos.
El problema es que estos controles a menudo viajan sin invitación cuando copias y pegas. Un espacio de ancho cero (U+200B) puede dividir una palabra en dos para el procesador de texto, aunque visualmente parezca una sola. Una marca de orden de bytes (BOM) al principio de un archivo puede hacer que un parser JSON falle estrepitosamente. Para limpiar esto, necesitas más que un simple "buscar y reemplazar"; necesitas entender qué estás borrando. Aquí te explico exactamente qué son estos personajes invisibles, por qué importan y cómo eliminarlos sin romper nada importante.
Qué son realmente los caracteres de ancho cero
Cuando hablamos de carácter de ancho cero un punto de código Unicode que ocupa cero unidades de avance en la pantalla pero afecta al procesamiento del texto, no nos referimos a un solo símbolo. Es una familia de controladores. Los tres más comunes son el Espacio de Ancho Cero (ZWSP), el Conector de Ancho Cero (ZWJ) y el No-Conector de Ancho Cero (ZWNJ).
El ZWSP (U+200B) es quizás el más molesto en contextos técnicos. Su trabajo original era ofrecer una oportunidad de salto de línea en idiomas donde las palabras no tienen espacios, como el chino o el japonés. Sin embargo, si aparece dentro de una variable en Python o JavaScript, rompe la sintaxis. El intérprete ve `mi_variable` y `mivariable` como cosas distintas porque ese carácter invisible cambia la cadena de bits. A diferencia de un espacio normal, el ZWSP no se elimina con las funciones estándar de recorte de espacios (`trim()` o `.strip()`), lo que lo hace difícil de detectar manualmente.
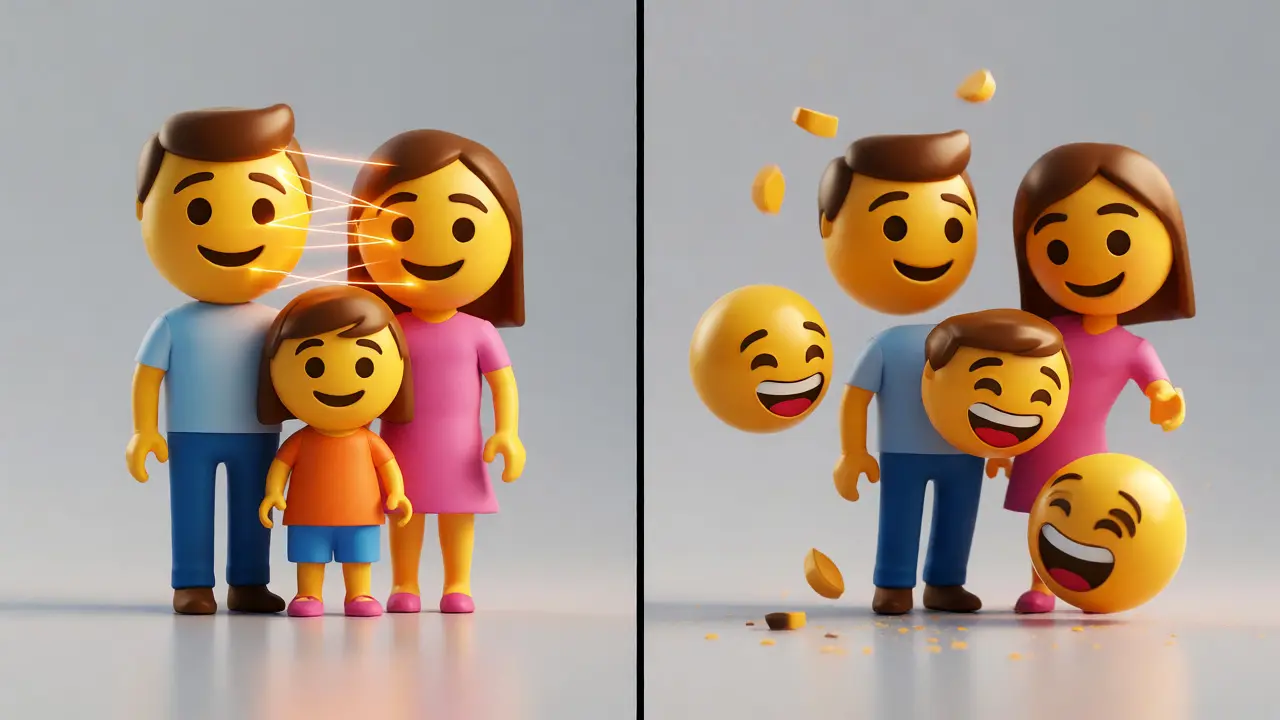
Luego están los conectores. El ZWJ (U+200D) es famoso por los emojis. Cuando ves el emoji de "familia" 👨👩👧👦, no es un solo glifo mágico; son cuatro emojis individuales unidos por ZWJs. Si borras todos los ZWJ indiscriminadamente, esa familia se separa en cuatro personas sueltas. El ZWNJ (U+200C) hace lo contrario: impide que dos letras se unan gráficamente, algo crucial en idiomas como el persa o el hindi. Borrarlo puede cambiar el significado de una palabra en esos idiomas.
La marca de orden de bytes (BOM): ¿Amigo o enemigo?
La Marca de Orden de Bytes, o BOM (Byte Order Mark), corresponde al carácter U+FEFF. Históricamente, servía para decirle al ordenador si un archivo estaba escrito en UTF-16 big-endian o little-endian. Hoy, en la mayoría de los entornos modernos que usan UTF-8, el BOM es opcional y a menudo innecesario.
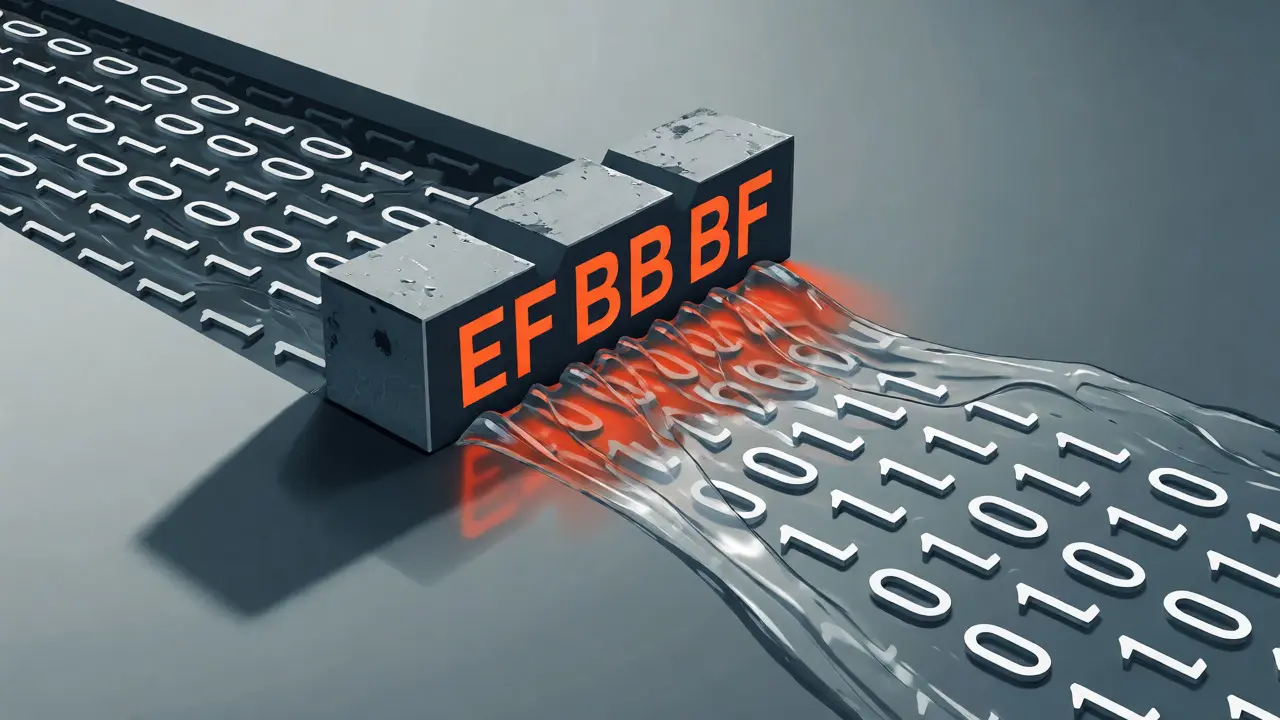
El problema surge cuando un editor de texto añade un BOM al inicio de un archivo UTF-8. Visualmente, el archivo empieza con la primera letra de tu código. Pero para muchos compiladores y librerías, el archivo empieza con tres bytes extraños (EF BB BF). Esto provoca errores de "símbolo inesperado" en scripts de shell, fallos al leer archivos CSV en Excel o problemas al parsear JSON. Aunque internamente U+FEFF puede actuar como un espacio de ancho cero, su posición al inicio del flujo de datos le da una semántica completamente distinta: es una firma de codificación, no un control de formato.
Por qué no puedes borrar todo a ciegas
Un error común es usar una expresión regular que elimine cualquier cosa que no sea alfanumérica. ¡Cuidado! Si haces eso, destruirás la integridad lingüística y visual de tu texto. Por ejemplo, si tienes un documento con banderas de subdivisiones geográficas (como la bandera de Inglaterra 🏴), estas dependen de secuencias complejas de caracteres de tag Unicode. Borrarlas convierte la bandera en un cuadrado vacío o en letras sueltas.
Además, hay un matiz importante relacionado con la Inteligencia Artificial. Muchos usuarios buscan un eliminador de marcas de agua de IA herramienta para limpiar caracteres ocultos de textos generados por modelos de lenguaje pensando que los modelos como ChatGPT o Claude dejan una firma digital invisible. La realidad es más sutil. En abril de 2025, se descubrió que algunas respuestas de ChatGPT contenían espacios estrechos de no salto (U+202F), probablemente un subproducto del entrenamiento. Estos sí se pueden borrar. Sin embargo, las marcas de agua estadísticas reales (como SynthID de Google o textGrain de OpenAI anunciado en octubre de 2026) no añaden caracteres; cambian la probabilidad de elección de palabras. Ningún eliminador de caracteres puede quitar esas marcas estadísticas, pero sí puede limpiar los residuos tipográficos accidentales que acompañan al texto.
Herramientas prácticas para limpiar tu texto
Para detectar y eliminar estos intrusos, necesitas una herramienta que entienda de puntos de código Unicode, no solo de patrones visuales. Puedes usar editores de código avanzados como VS Code, que tienen opciones para "mostrar caracteres invisibles", pero esto solo sirve para verlos, no siempre para limpiarlos masivamente de forma segura.
Una opción más eficiente para usuarios generales es utilizar un analizador dedicado que funcione directamente en el navegador, garantizando privacidad. Herramientas como esta utilidad gratuita permiten pegar tu texto y escanean cada carácter. Lo interesante es que no solo borra, sino que muestra qué encontró: cuántos espacios de ancho cero, si hay marcas BOM internas o si existen controles bidireccionales peligrosos. Te permite decidir qué mantener. Por ejemplo, puedes optar por conservar los conectores de emojis (ZWJ) para no romper tus iconos, mientras eliminas los espacios de ancho cero accidentales que rompen tu código.
Esta aproximación es superior a los scripts genéricos porque ofrece contexto. Vaulternal, la empresa detrás de esta herramienta, aplica la misma filosofía de privacidad a sus servicios principales: el cifrado ocurre en tu dispositivo antes de que los datos salgan a internet, asegurando que nadie más pueda leer tu contenido sensible. Puedes conocer más sobre su enfoque en su sitio principal.
Cómo implementar la limpieza en tu flujo de trabajo
Si eres desarrollador, no confíes en copiar y pegar sin verificar. Aquí tienes una estrategia sencilla:
- Detecta primero: Antes de integrar texto externo en tu base de datos o aplicación, pásalo por un validador. Busca específicamente U+200B, U+200C, U+200D, U+2060 y U+FEFF.
- Distingue el contexto: Si el U+FEFF está al principio absoluto del archivo, trátalo como una BOM y decide si tu sistema la soporta. Si está en medio, es un carácter de formato accidental y probablemente deba irse.
- Preserva lo esencial: Configura tus reglas de limpieza para ignorar los ZWJ si trabajas con emojis o idiomas complejos. Eliminarlos puede tener consecuencias visuales inesperadas.
- Vigila los controles bidireccionales: Caracteres como U+202A a U+202E pueden alterar el orden de lectura del texto. Son útiles en mezclas de árabe e inglés, pero en código fuente suelen ser señales de ataques tipo "Trojan Source" o errores graves de copia.
Recuerda que limpiar formato no es ocultar pruebas. Si un texto viene de una IA, tiene marcas estadísticas inherentes que no desaparecerán al borrar un espacio invisible. Limpiar los caracteres ocultos es simplemente mantenimiento higiénico de los datos, necesario para que tu software interprete correctamente la información que le entregas.
¿Los caracteres de ancho cero prueban que un texto fue generado por IA?
No necesariamente. Aunque algunos modelos de IA han producido ocasionalmente espacios estrechos o caracteres extraños debido a artefactos de tokenización, muchos programas tradicionales (editores de PDF, hojas de cálculo, CMS) insertan estos caracteres rutinariamente. Su presencia indica un problema de formato, no autoría.
¿Puedo eliminar todas las marcas de agua de la IA borrando caracteres invisibles?
Solo puedes eliminar los residuos físicos (como espacios de ancho cero o BOMs). Las marcas de agua estadísticas modernas (como SynthID o textGrain) funcionan modificando la estructura léxica y probabilística del texto, no añadiendo caracteres. Estas últimas permanecen intactas tras la limpieza de caracteres.
¿Qué pasa si borro los conectores de ancho cero (ZWJ) de mis emojis?
Los emojis compuestos (como familias, parejas o profesiones con género) se descompondrán en sus partes individuales. Por ejemplo, el emoji de hombre cocinando podría aparecer como un hombre y luego una sartén, en lugar de un solo ícono integrado.
¿Es seguro usar herramientas online para limpiar documentos confidenciales?
Depende de la arquitectura de la herramienta. Las mejores implementaciones ejecutan todo el proceso en el lado del cliente (tu navegador) mediante JavaScript, sin enviar el texto a ningún servidor. Verifica siempre la política de privacidad o busca indicadores de que el procesamiento es local.
¿Cómo afecta la Marca de Orden de Bytes (BOM) a los archivos JSON?
Muchos parsers JSON estrictos fallan si encuentran un BOM al inicio del archivo porque esperan que el primer carácter sea una llave de apertura ({) o un corchete ([). El BOM se interpreta como un carácter inválido, provocando errores de análisis.
Contanza Huenupil
octubre 19, 2026 AT 10:59Me pasó exactamente esto con un script de Python que me bajaba datos de una API. Llevaba horas peleando con un error de sintaxis en una variable que visualmente estaba perfecta, y resultó ser un ZWSP pegado al final del nombre. Es increíble cómo algo tan pequeño te puede hacer perder la tarde entera.